调了几十组参数才找到一个赚钱的,这个结果还能信吗?
参数稍微一改,利润就没了?先看附近设置,再换段没用来调参的行情,别只被最好看的那张曲线说服。
调了一下午参数,终于找到一组赚钱的,结果把数字改小一点,利润就没了。好不容易找到的策略,怎么这么挑设置?先别急着用真金白银试答案:看它换个相近设置、换段没用来调参的行情还能不能赚,才知道接下来值不值得继续研究。
参数稍微一改,回测就不赚钱了,为什么?
参数,就是策略里能调的设置。比如判断买卖时,要参考前面多少根 K 线。多看一点、少看一点,策略做出的交易就可能不同。
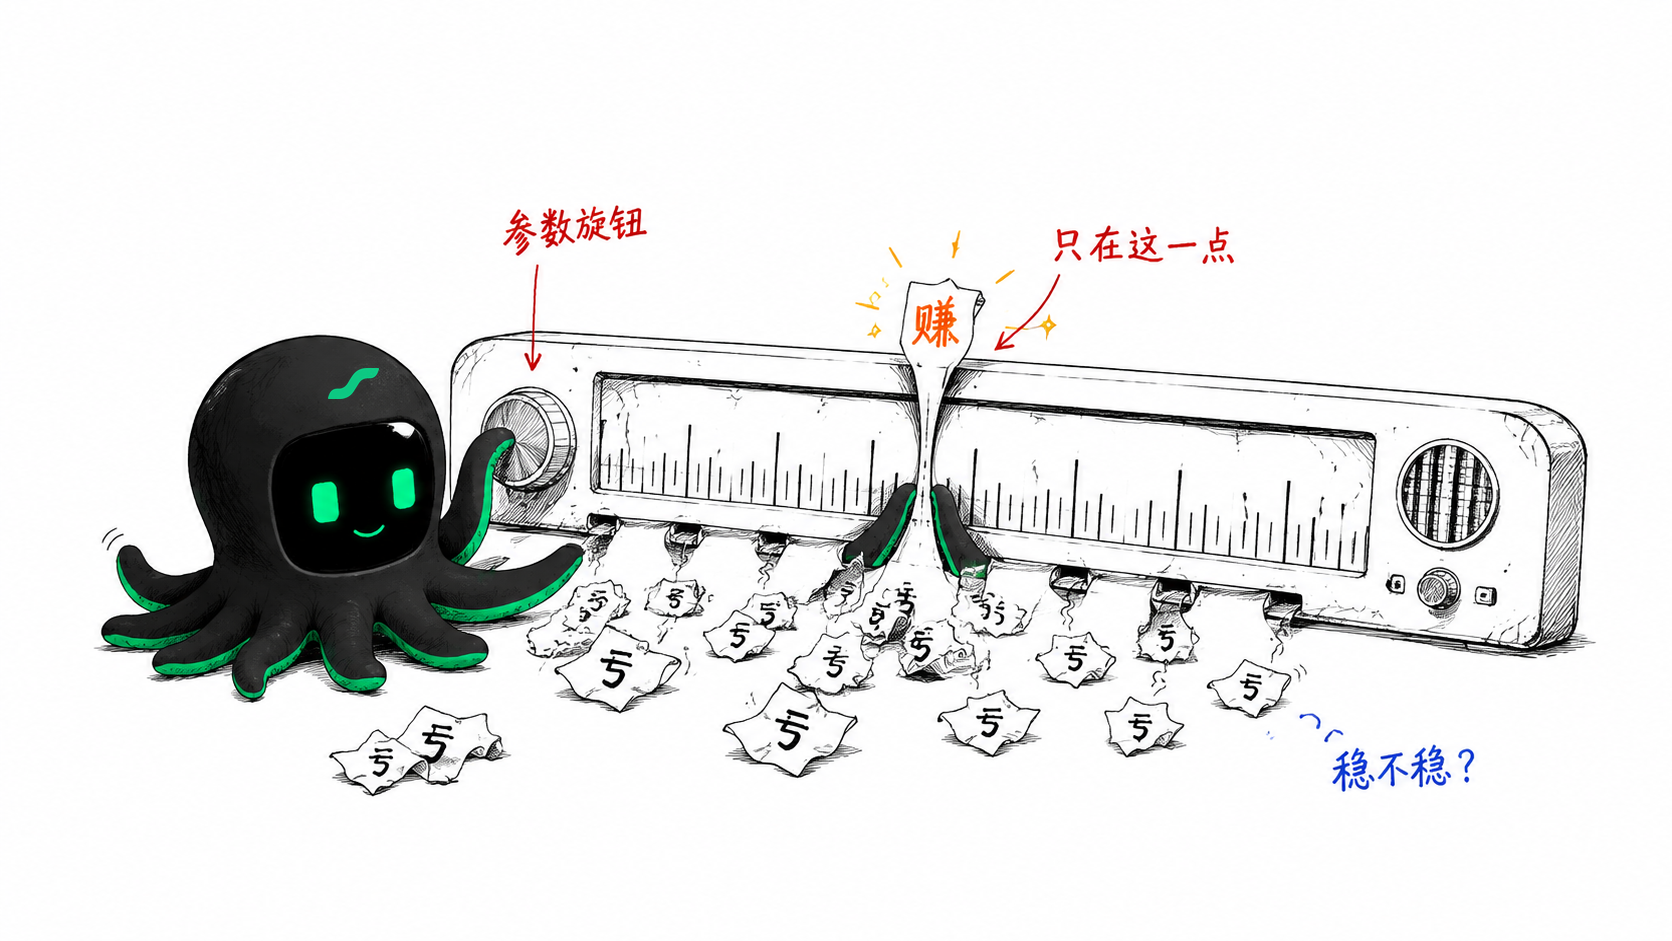
假设其他条件不变,只调整这个设置,出现了下表的结果:相邻的两个设置都亏钱,夹在中间的那个却赚钱。值得追问的是:为什么只差一点,结果就变了?
| 往前看多少根 K 线 | 回测结果 | 需要留意什么 |
|---|---|---|
| 20 | 亏损 | 少看一根,亏钱 |
| 21 | 盈利 | 只有这个设置赚钱 |
| 22 | 亏损 | 多看一根,也亏钱 |
这时最该看的,是那一根 K 线到底改变了什么。它让策略避开了几笔亏损?还是让它赶上了一笔大涨?如果说不清,只能说明 21 在这次比较里赢了,还不能说明它换段行情也好用。
同一套题做了几十遍,边看答案边改,最后考了高分。当然开心,但咱们还没换卷子呢。调参也会遇到类似的问题:设置越来越适合这段历史,却未必适合之后的行情。这叫回测过拟合。
所以,试过很多组本身不是错。问题是把失败的记录都扔了,只拿冠军那张曲线证明策略好。相关研究讨论的正是:挑选成绩的过程,也会影响最后看到的成绩。
换段没用过的行情,策略还能赚钱吗?
先把现在的版本留住,别一边检查一边继续改。接下来做的事,最好能回答一个明确的问题,而不只是再刷出一张更漂亮的曲线。
先看相近的设置,是一起赚钱,还是只有一个赚钱?
把试过的参数和结果排成表,赚钱、亏钱的都留着。除了赚亏,还要记下测试日期、费用、回撤和交易笔数。回撤说的是资金从高点往下掉了多少。
如果 20、21、22 都还不错,和只有 21 赚钱,是两种不同情况。但别到这就下结论。还要看看参数稍微一动,买卖时间和交易笔数是不是变了很多。
再换一段没用来调参的行情
定好规则后,拿一段之前没用来挑参数的数据再测。这才像换了一份新考卷,通常叫样本外测试。
如果看完新结果又继续改参数,这段行情也被你用来调参了。不能改完再用它证明“没见过也能赚”。卷子都订正过了,就不是第一次考试了。
如果定期调参,也按当时能知道的信息测试
比如用前一段行情选设置,再看后一段表现。然后往后挪,重复同样的步骤。这叫滚动检验。关键是:做前面的决定时,不能偷看后面的行情。
测试数据的使用方法也强调这一点。新数据上表现不错,能多提供一份参考,但不能保证今后一直赚钱。
最后查费用和那几笔“大功臣”
把费用按计划使用的方式算清楚,看看利润还剩多少。再找出最赚钱的几笔:如果大部分利润都靠它们撑着,就要研究这种机会后来还能不能遇到。
只有一个设置赚钱,就一定该放弃吗?
不一定。有些规则刚好越过某个条件,就会多做或少做一笔交易。交易本来就少时,一笔大赚大亏也能改变整个结果。要查的是变化有没有道理,不是见到孤零零的赢家就判它没用。
反过来,好几组设置都赚钱,也可能是反复挑出来的。无论结果长什么样,都得留下自己到底试过什么。
调了几十组参数,怎么比较这些回测结果?
调了几十次,结果一多,就容易记不清哪组设置对应哪次回测。先把每次试过的参数和结果放在一起,比较时才不会弄混。
把各组参数和结果放在一起,交给 EdgePilot Research 对话,就可以让 AI 帮你解释差别、列出下一步该查什么。它分析的是你带来的材料,所以别只给最好看的那一份。
安装并启用 EdgePilot Research 官方插件后,我们实际问了这个问题:
用 EdgePilot Research 帮我检查:我调了几十组参数,只有一组赚钱,这个结果能信吗?请简洁说明优先检查什么,以及我应该提供哪些结果。
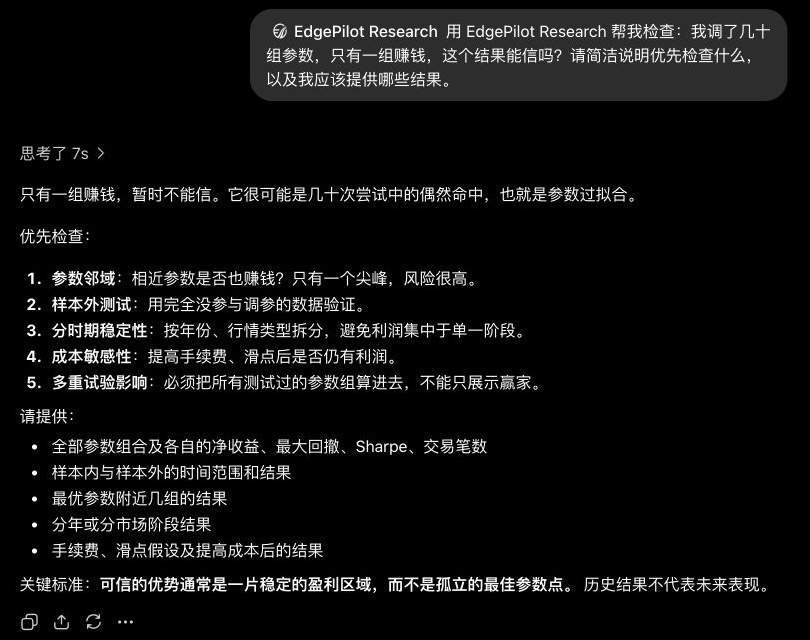
EdgePilot 建议先看相近参数、没参与调参的数据,以及费用对结果的影响。接着就可以把例子里的 20、21、22 一起带上,追问:“为什么只多看一根 K 线,结果就变了?”再补充哪些行情已经用来选过参数。
还有一个概率例子能说明:多试几次,更容易碰到一次看起来不错的结果。假设一种检验在没有真实效果时,每次有 5% 的机会误报。如果做 30 次彼此独立的检验,至少误报一次的概率约为 79%。
这不是策略有 79% 的概率失败。它只是帮助理解反复测试的影响。实际调参的结果往往相互关联;回测赚钱,也不等于通过了这里说的统计检验。
教学计算:1 − 0.9530 ≈ 78.5%。
计算的是:30 次独立检验中,至少一次误报的概率。每次误报概率假设为 5%。
| 你带什么 | 请 Research 帮你看什么 | 接着查哪里 |
|---|---|---|
| 所有参数和对应结果 | 赚钱那组和其他组差在哪 | 查哪几笔交易为什么变了 |
| 用过的行情和调参过程 | 哪些数据已经参与选设置 | 留哪段没用过的行情再测 |
| 费用明细和每笔赚亏 | 利润被费用吃掉多少、是否靠少数大单 | 先改费用假设,还是查交易机会 |
如果要继续测试 Research 支持的已审核研究策略包,还可以让它运行历史回测,留下策略版本、参数、市场、费用设置和结果。下次比较时,就有原记录可查,不用猜哪份“最终版”才是真的。
拿到回答后,先做哪一步?
只有一个设置赚钱,先查它究竟改了哪些交易。相近设置也不错,就检查有没有拿没参与调参的行情测过。几项检查都还不错,再按原计划继续研究,把设置和结果一起保存。
那试多少组参数,才不算太多?
没有一个通用的安全次数。试的设置有多相似、可用数据有多少、最后怎么挑赢家,都会影响判断。与其卡在“能试几次”,不如先把自己试过什么记全。
先别急着再调一轮参数。把已经试过的设置和结果整理好,用 EdgePilot Research 梳理这次调参结果,看看下一步最值得验证什么。
相关阅读:扣完交易成本后还剩多少利润。
下一步要问的,是这组设置换到没用来调参的数据上还能怎样。先看滚动验证怎么把这场考试分开;想找一个具体研究对象,也可以到策略库查看候选策略的公开证据。
参考资料
本文用于交易研究与软件测试教育,不构成投资建议。教学案例不代表实际策略业绩;历史与模拟结果不保证未来表现。